NVIDIA A100 80GB
La NVIDIA A100 80GB es una GPU de nivel empresarial basada en la arquitectura Ampere y cuenta con 80 GB de memoria con 2000 GB/s de ancho de banda de memoria y un TDP de 400 W. Ofrece 19,5 TFLOPS de rendimiento FP32 y 312 TFLOPS de rendimiento tensorial FP16. Disponible actualmente en 16 proveedores desde 0,34 €/GPU/hora, con una mediana de mercado de 1,33 €/GPU/hora en 92 configuraciones.
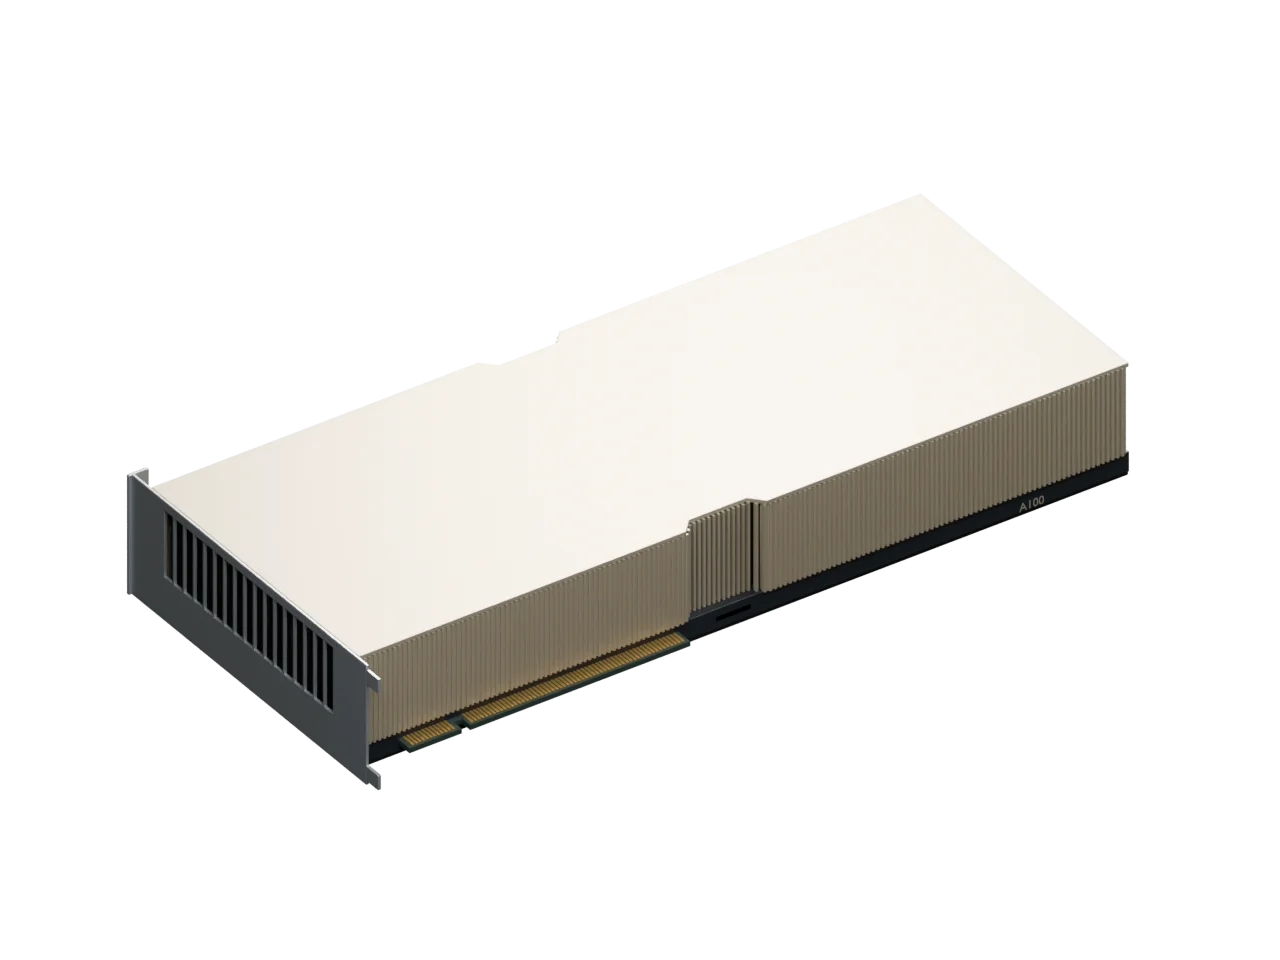
A100 80GB · diseño de referencia PCIe
Ilustración PCIe. Las configuraciones pueden usar SXM u otras variantes.
Especificaciones de hardware
Iguales en todos los proveedores
Precio mediano entre todos los proveedores
16 ofertas de 16 proveedores
Ordenadas por precio ascendente. Compara configuraciones lado a lado.
| Proveedor | Cantidad | vCPU | RAM | Región | Por GPU/h | Total/h | Acción |
|---|---|---|---|---|---|---|---|
| ×1 | 16 | 125 GB |   | 1,601 € | 1,60 € | Abrir | |
| ×4 | 64 | 504 GB |   +4 | Desde0,340 € -6,2 % 30d | Desde1,36 € | Abrir | |
Hasta89 €crédito | ×1 | — | — |  | Desde0,957 € | Desde0,96 € | Abrir |
 Thunder ComputeEnlace de referido | ×1 | 8 | 64 GB | -- | Desde0,975 € 0,0 % 30d | Desde0,97 € | Abrir |
| ×1 | 28 | 120 GB |  | Desde1,207 € +3,7 % 30d | Desde1,21 € | Abrir | |
| ×8 | 240 | 1,25 TB | | Desde1,268 € +25,0 % 30d | Desde10,14 € | Abrir | |
 OblivusEnlace de referido | ×1 | 28 | 120 GB | | Desde1,315 € +6,8 % 30d | Desde1,31 € | Abrir |
 Sesterce CloudEnlace de referido | ×8 | 240 | 1,25 TB | | Desde1,328 € -14,0 % 30d | Desde10,63 € | Abrir |
| ×1 | 16 | 120 GB | | 1,333 € 0,0 % 30d | Desde1,33 € | Abrir | |
 LiumEnlace de referido | ×8 | 240 | 1,73 TB | | 1,503 € +36,6 % 30d | 12,02 € | Abrir |
| ×1 | 28 | 120 GB | | Desde1,520 € -9,5 % 30d | Desde1,52 € | Abrir | |
| ×1 | 28 | 120 GB | | 1,574 € +18,1 % 30d | Desde1,57 € | Abrir | |
Hasta447 €crédito | ×1 | 16 | 125 GB | | 1,601 € 0,0 % 30d | 1,60 € | Abrir |
| ×1 | 22 | 120 GB | -- | Desde1,749 € +12,7 % 30d | Desde1,75 € | Abrir | |
| ×1 | 30 | 200 GB | | Desde1,780 € 0,0 % 30d | Desde1,78 € | Abrir | |
 Theta EdgeCloudEn tendencia | ×1 | 10 | 80 GB | -- | 1,780 € | Desde1,78 € | Abrir |
Hasta1 €crédito | ×8 | 64 | 512 GB |  | Desde1,793 € -0,2 % 30d | Desde14,34 € | Abrir |






LLM que caben en la NVIDIA A100 80GB
VRAM estimada para LLM populares de pesos abiertos con precisión de 16 bits (FP16/BF16), 8 bits (FP8/INT8) y 4 bits (INT4/MXFP4), con 80 GB por GPU. Se muestran los 12 modelos más grandes que caben.
| Modelo | Parámetros | 16 bits | 8 bits | 4 bits |
|---|---|---|---|---|
| Kimi K2.5 Moonshot AI | 1 B 32 mil M activos | — No publicado | — No publicado | 714 GB Ajustado en 8× · 7 % libre |
| GLM-5.2 Z.ai | 753 mil M | — No publicado | 994 GB Demasiado grande | 579 GB 8× · 61 GB libres |
| DeepSeek R1 DeepSeek | 671 mil M 37 mil M activos | — No publicado | 826 GB Demasiado grande | 481 GB 8× · 159 GB libres |
| DeepSeek V4 Flash DeepSeek | 284 mil M | — No publicado | — No publicado | 192 GB 4× · 128 GB libres o 2× · 0 % libre |
| Solar Open2 250B Upstage | 250 mil M 15 mil M activos | 601 GB 8× · 39 GB libres | 330 GB 8× · 310 GB libres o 4× · 16 % libre | 192 GB 4× · 128 GB libres |
| Qwen3 235B-A22B Alibaba | 235 mil M 22 mil M activos | 564 GB 8× · 76 GB libres | 310 GB 4× · 9,7 GB libres | 181 GB 4× · 139 GB libres o 2× · 6 % libre |
| Laguna-S 2.1 Poolside | 118 mil M 8 mil M activos | 282 GB 4× · 38 GB libres | 155 GB 2× · 4,8 GB libres | 90 GB 2× · 70 GB libres o 1× · 6 % libre |
| gpt-oss-120b OpenAI | 117 mil M 5,1 mil M activos | — No publicado | — No publicado | 78 GB 1× · 1,7 GB libres |
| Qwen3.6 35B-A3B Alibaba | 35 mil M 3 mil M activos | 86 GB 2× · 74 GB libres o 1× · 11 % libre | 47 GB 1× · 33 GB libres | 28 GB 1× · 52 GB libres |
| Qwen3 32B Alibaba | 32,8 mil M | 79 GB 1× · 1,4 GB libres | 43 GB 1× · 37 GB libres | 25 GB 1× · 55 GB libres |
| Gemma 4 31B Google | 31,3 mil M | 75 GB 1× · 4,9 GB libres | 41 GB 1× · 39 GB libres | 24 GB 1× · 56 GB libres |
| GLM-4.7 Flash Z.ai | 31,2 mil M | 75 GB 1× · 5,1 GB libres | 41 GB 1× · 39 GB libres | 24 GB 1× · 56 GB libres |
Estimaciones: pesos del modelo más un 20 % para la caché KV y la sobrecarga de ejecución, con contextos cortos. Los contextos largos y los lotes grandes necesitan más. Las filas marcadas como «ajustadas» albergan los pesos, pero no ese margen completo. Una cifra ×N es la VRAM total de N de estas GPU y no afirma nada sobre el rendimiento de la interconexión. Cómo lo estimamos · Empezar por el modelo
¿Quieres más de esta página?
¿Datos incorrectos?