NVIDIA L40S
La NVIDIA L40S es una GPU de nivel empresarial basada en la arquitectura Ada Lovelace y cuenta con 48 GB de memoria con 864 GB/s de ancho de banda de memoria y un TDP de 350 W. Ofrece 91,6 TFLOPS de rendimiento FP32 y 362 TFLOPS de rendimiento tensorial FP16. Disponible actualmente en 11 proveedores desde 0,34 €/GPU/hora, con una mediana de mercado de 1,02 €/GPU/hora en 43 configuraciones.
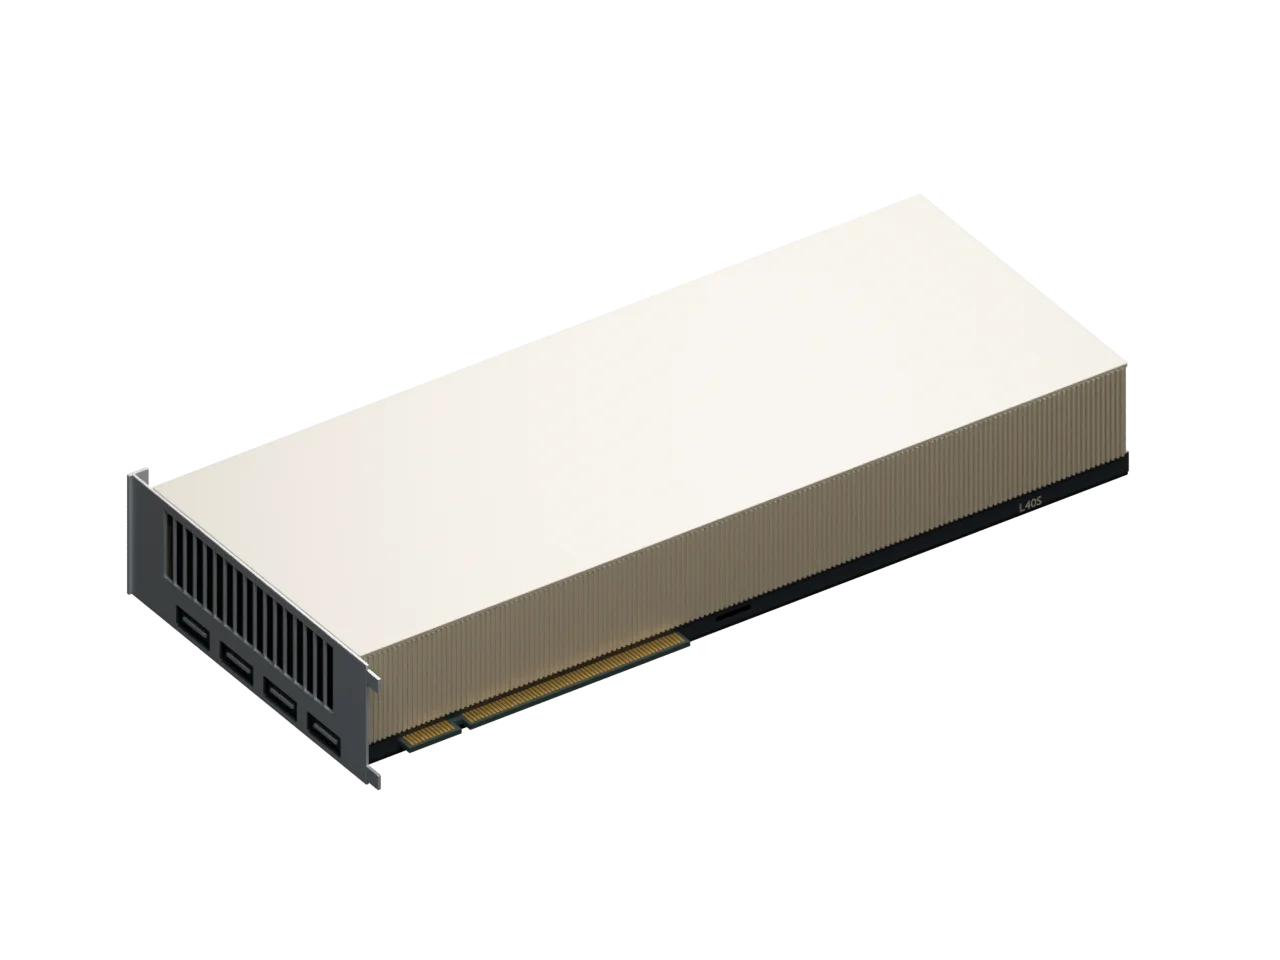
L40S · diseño de referencia PCIe
Diseño representativo. El hardware del proveedor puede variar.
Especificaciones de hardware
Iguales en todos los proveedores
Precio mediano entre todos los proveedores
12 ofertas de 11 proveedores
Ordenadas por precio ascendente. Compara configuraciones lado a lado.
| Proveedor | Cantidad | vCPU | RAM | Región | Por GPU/h | Total/h | Acción |
|---|---|---|---|---|---|---|---|
| ×1 | 16 | 62 GB |    | 0,973 € | 0,97 € | Abrir | |
Hasta4 €crédito | ×4 | 46 | 283 GB | | 0,339 € 0,0 % 30d | 1,36 € | Abrir |
| ×1 | 24 | 118 GB |   +4 | Desde0,384 € +1,3 % 30d | Desde0,38 € | Abrir | |
 Novita AIEnlace de referido | ×1 | 22 | 125 GB |    +7 | 0,491 € | 0,49 € | |
| ×4 | 46 | 283 GB | | Desde0,714 € 0,0 % 30d | Desde2,86 € | Abrir | |
| ×2 | 44 | 256 GB | | Desde0,825 € +70,3 % 30d | Desde1,65 € | Abrir | |
Hasta446 €crédito | ×1 | 16 | 62 GB | | 0,973 € | 0,97 € | Abrir |
| ×1 | 12 | 72 GB | | 1,017 € +17,5 % 30d | Desde1,02 € | Abrir | |
Hasta1 €crédito | ×8 | 64 | 1,5 TB | | Desde1,107 € -1,1 % 30d | Desde8,86 € | Abrir |
| ×1 | 16 | 180 GB | -- | Desde1,392 € | Desde1,39 € | Abrir | |
| ×1 | 8 | 96 GB |  | 1,470 € -3,3 % 30d | Desde1,47 € | Abrir | |
 Sesterce CloudEnlace de referido | ×10 | 80 | 1,44 TB | | Desde1,472 € 0,0 % 30d | Desde14,72 € | Abrir |
| ×1 | 20 | 60 GB | -- | Desde1,483 € +19,0 % 30d | Desde1,48 € | Abrir |




LLM que caben en la NVIDIA L40S
VRAM estimada para LLM populares de pesos abiertos con precisión de 16 bits (FP16/BF16), 8 bits (FP8/INT8) y 4 bits (INT4/MXFP4), con 48 GB por GPU. Se muestran los 12 modelos más grandes que caben.
| Modelo | Parámetros | 16 bits | 8 bits | 4 bits |
|---|---|---|---|---|
| DeepSeek R1 DeepSeek | 671 mil M 37 mil M activos | — No publicado | 826 GB Demasiado grande | 481 GB Ajustado en 10× · 19 % libre |
| DeepSeek V4 Flash DeepSeek | 284 mil M | — No publicado | — No publicado | 192 GB Cabe justo en 4× |
| Solar Open2 250B Upstage | 250 mil M 15 mil M activos | 601 GB Demasiado grande | 330 GB 8× · 54 GB libres | 192 GB 8× · 192 GB libres o 4× · 19 % libre |
| Qwen3 235B-A22B Alibaba | 235 mil M 22 mil M activos | 564 GB Ajustado en 10× · 2 % libre | 310 GB 8× · 74 GB libres | 181 GB 4× · 11 GB libres |
| Laguna-S 2.1 Poolside | 118 mil M 8 mil M activos | 282 GB 8× · 102 GB libres | 155 GB 4× · 37 GB libres | 90 GB 2× · 5,7 GB libres |
| gpt-oss-120b OpenAI | 117 mil M 5,1 mil M activos | — No publicado | — No publicado | 78 GB 2× · 18 GB libres |
| Qwen3.6 35B-A3B Alibaba | 35 mil M 3 mil M activos | 86 GB 2× · 9,7 GB libres | 47 GB Cabe justo en 1× | 28 GB 1× · 20 GB libres |
| Qwen3 32B Alibaba | 32,8 mil M | 79 GB 2× · 17 GB libres | 43 GB 1× · 4,8 GB libres | 25 GB 1× · 23 GB libres |
| Gemma 4 31B Google | 31,3 mil M | 75 GB 2× · 21 GB libres | 41 GB 1× · 6,7 GB libres | 24 GB 1× · 24 GB libres |
| GLM-4.7 Flash Z.ai | 31,2 mil M | 75 GB 2× · 21 GB libres | 41 GB 1× · 6,8 GB libres | 24 GB 1× · 24 GB libres |
| Qwen3.6 27B Alibaba | 27,8 mil M | 67 GB 2× · 29 GB libres | 37 GB 1× · 11 GB libres | 21 GB 1× · 27 GB libres |
| Mistral Small 3.2 24B Mistral AI | 24 mil M | 58 GB 2× · 38 GB libres | 32 GB 1× · 16 GB libres | 18 GB 1× · 30 GB libres |
Estimaciones: pesos del modelo más un 20 % para la caché KV y la sobrecarga de ejecución, con contextos cortos. Los contextos largos y los lotes grandes necesitan más. Las filas marcadas como «ajustadas» albergan los pesos, pero no ese margen completo. Una cifra ×N es la VRAM total de N de estas GPU y no afirma nada sobre el rendimiento de la interconexión. Cómo lo estimamos · Empezar por el modelo
¿Quieres más de esta página?
¿Datos incorrectos?