Die NVIDIA RTX 5090 ist eine Consumer- GPU, basiert auf der Blackwell-Architektur und verfügt über 32 GB Speicher mit 1.792 GB/s Speicherbandbreite und einer TDP von 575 W. Sie liefert 104 TFLOPS FP32-Rechenleistung. Derzeit bei 11 Anbieter verfügbar, ab 0,37 €/GPU/Stunde, mit einem Marktmedian von 0,64 €/GPU/Stunde über 62 Konfigurationen.
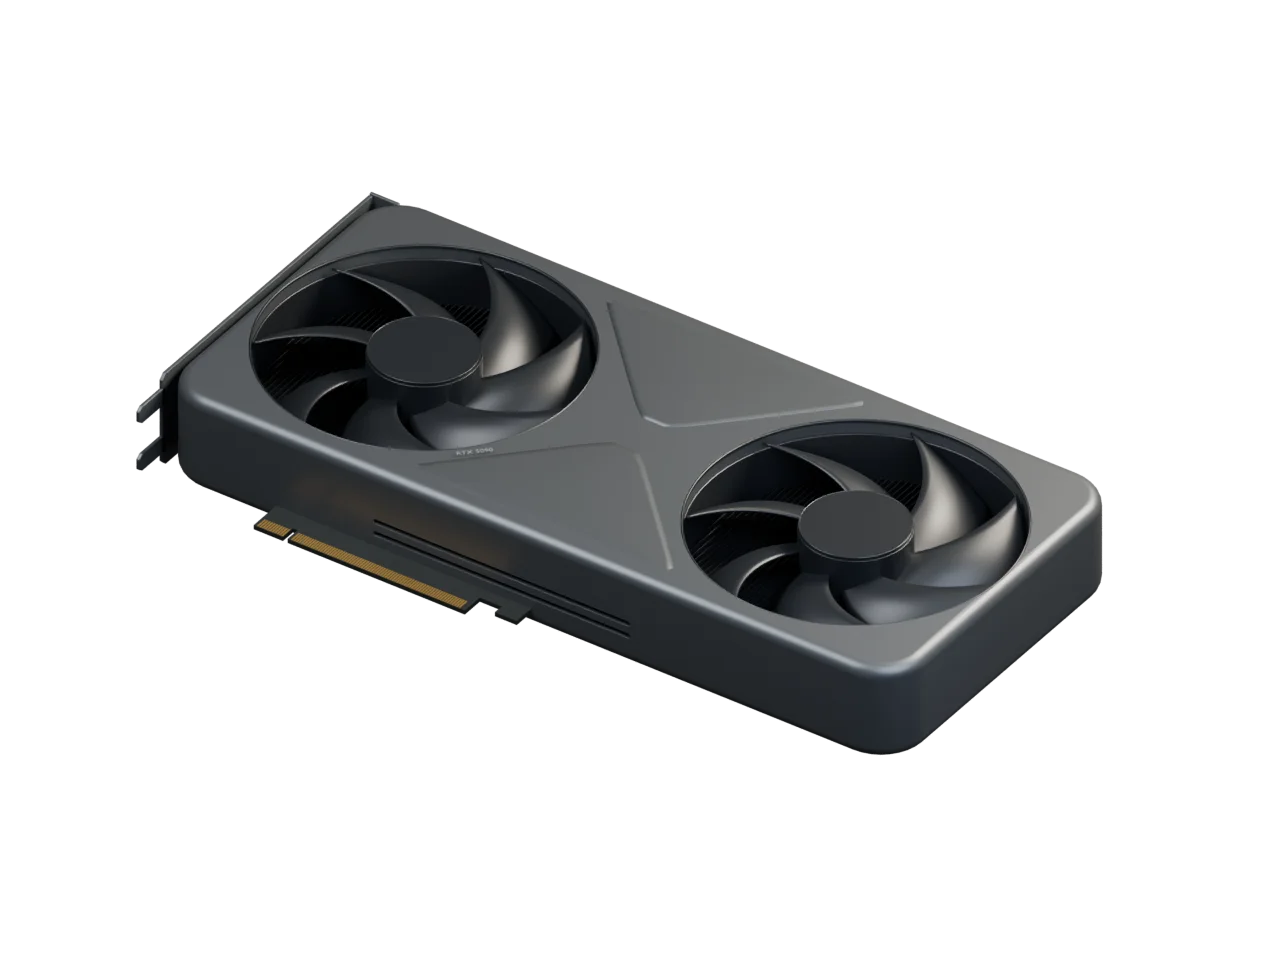
RTX 5090 · Founders-Edition-Referenz
Repräsentatives Design. Die Hardware des Anbieters kann abweichen.
Hardware-Spezifikationen
Gleich bei allen Anbietern
Medianpreis über alle Anbieter
13 Angebote von 11 Anbietern
Sortiert nach aufsteigendem Preis. Konfigurationen direkt vergleichen.
| Anbieter | Anzahl | vCPU | RAM | Region | Pro GPU/Std. | Gesamt/Std. | Aktion |
|---|---|---|---|---|---|---|---|
| ×1 | 15 | 117 GB |  | 1,062 € | 1,06 € | Starten | |
| ×1 | 32 | 31 GB |    +14 | Ab0,366 € -5,8 % 30T | Ab0,37 € | Starten | |
 LiumEmpfehlungslink | ×8 | 512 | 251 GB |  | 0,491 € -8,3 % 30T | 3,93 € | Starten |
 Novita AIEmpfehlungslink | ×1 | 16 | 58 GB | | Ab0,500 € | Ab0,50 € | |
Bis zu89 €Guthaben | ×1 | — | — | | 0,509 € 0,0 % 30T | 0,51 € | Starten |
| ×1 | — | 73 GB | | 0,518 € | 0,52 € | Starten | |
 Theta EdgeCloudIm Trend | ×1 | 24 | 15 GB | | 0,580 € -9,1 % 30T | 0,58 € | Starten |
| ×1 | 12 | 120 GB | | 0,616 € +5,7 % 30T | 0,62 € | Starten | |
 Sesterce CloudEmpfehlungslink | ×1 | 12 | 120 GB | | Ab0,638 € -7,1 % 30T | Ab0,64 € | Starten |
 Nova CloudEmpfehlungslink | ×1 | 22 | 84 GB | | 0,643 € +14,3 % 30T | 0,64 € | Starten |
| ×1 | 12 | 120 GB | | 0,759 € +10,4 % 30T | 0,76 € | Starten | |
| ×1 | — | — | -- | 0,803 € +30,0 % 30T | 0,80 € | ||
Bis zu446 €Guthaben | ×1 | 15 | 117 GB | | 1,062 € 0,0 % 30T | 1,06 € | Starten |
Bis zu178 €Guthaben | ×1 | Separat berechnet | Separat berechnet | -- | 1,151 € 0,0 % 30T | Ab1,15 € | Starten |



LLMs, die auf die NVIDIA RTX 5090 passen
Geschätzter VRAM-Bedarf beliebter Open-Weight-LLMs bei 16 Bit (FP16/BF16), 8 Bit (FP8/INT8) und 4 Bit (INT4/MXFP4), bei 32 GB pro GPU. Gezeigt werden die 12 größten passenden Modelle.
| Modell | Parameter | 16 Bit | 8 Bit | 4 Bit |
|---|---|---|---|---|
| DeepSeek V4 Flash DeepSeek | 284 Mrd. | — Nicht veröffentlicht | — Nicht veröffentlicht | 192 GB Passt knapp auf 6× |
| Solar Open2 250B Upstage | 250 Mrd. 15 Mrd. aktiv | 601 GB Zu groß | 330 GB Knapp auf 9× · 4 % übrig | 192 GB 8× · 64 GB frei oder 6× · 19 % übrig |
| Qwen3 235B-A22B Alibaba | 235 Mrd. 22 Mrd. aktiv | 564 GB Zu groß | 310 GB Knapp auf 9× · 11 % übrig | 181 GB 6× · 11 GB frei |
| Laguna-S 2.1 Poolside | 118 Mrd. 8 Mrd. aktiv | 282 GB 9× · 5,8 GB frei oder 8× · 8 % übrig | 155 GB 6× · 37 GB frei | 90 GB 4× · 38 GB frei |
| gpt-oss-120b OpenAI | 117 Mrd. 5,1 Mrd. aktiv | — Nicht veröffentlicht | — Nicht veröffentlicht | 78 GB 4× · 50 GB frei |
| Qwen3.6 35B-A3B Alibaba | 35 Mrd. 3 Mrd. aktiv | 86 GB 4× · 42 GB frei | 47 GB 2× · 17 GB frei | 28 GB 1× · 4,4 GB frei |
| Qwen3 32B Alibaba | 32,8 Mrd. | 79 GB 4× · 49 GB frei | 43 GB 2× · 21 GB frei | 25 GB 1× · 6,8 GB frei |
| Gemma 4 31B Google | 31,3 Mrd. | 75 GB 4× · 53 GB frei oder 2× · 2 % übrig | 41 GB 2× · 23 GB frei | 24 GB 1× · 8 GB frei |
| GLM-4.7 Flash Z.ai | 31,2 Mrd. | 75 GB 4× · 53 GB frei oder 2× · 2 % übrig | 41 GB 2× · 23 GB frei | 24 GB 1× · 8 GB frei |
| Qwen3.6 27B Alibaba | 27,8 Mrd. | 67 GB 4× · 61 GB frei oder 2× · 15 % übrig | 37 GB 2× · 27 GB frei oder 1× · 4 % übrig | 21 GB 1× · 11 GB frei |
| Mistral Small 3.2 24B Mistral AI | 24 Mrd. | 58 GB 2× · 6,4 GB frei | 32 GB Passt knapp auf 1× | 18 GB 1× · 14 GB frei |
| gpt-oss-20b OpenAI | 21 Mrd. 3,6 Mrd. aktiv | — Nicht veröffentlicht | — Nicht veröffentlicht | 17 GB 1× · 15 GB frei |
Schätzungen: Modellgewichte plus 20 % für KV-Cache und Laufzeit-Overhead, bei kurzen Kontextlängen. Lange Kontexte und große Batches benötigen mehr. Als „knapp“ markierte Zeilen fassen die Gewichte, aber nicht diesen vollen Puffer. Ein ×N-Wert ist der gesamte VRAM über N dieser GPUs und sagt nichts über den Durchsatz der Verbindung aus. Wie wir das schätzen · Stattdessen vom Modell aus starten
Ähnliche GPUs
Mehr ähnliche GPUs in
Mehr von dieser Seite?
Falsche Daten?