Carte grand public, le GPU NVIDIA RTX 4090 repose sur l'architecture Ada Lovelace et dispose de 24 GB de mémoire, avec une bande passante mémoire de 1 008 GB/s et un TDP de 450 W. Il offre 82,6 TFLOPS de performances FP32. Actuellement disponible chez 8 fournisseurs à partir de 0,25 €/GPU/heure, avec une médiane du marché de 0,58 €/GPU/heure sur 68 configurations.
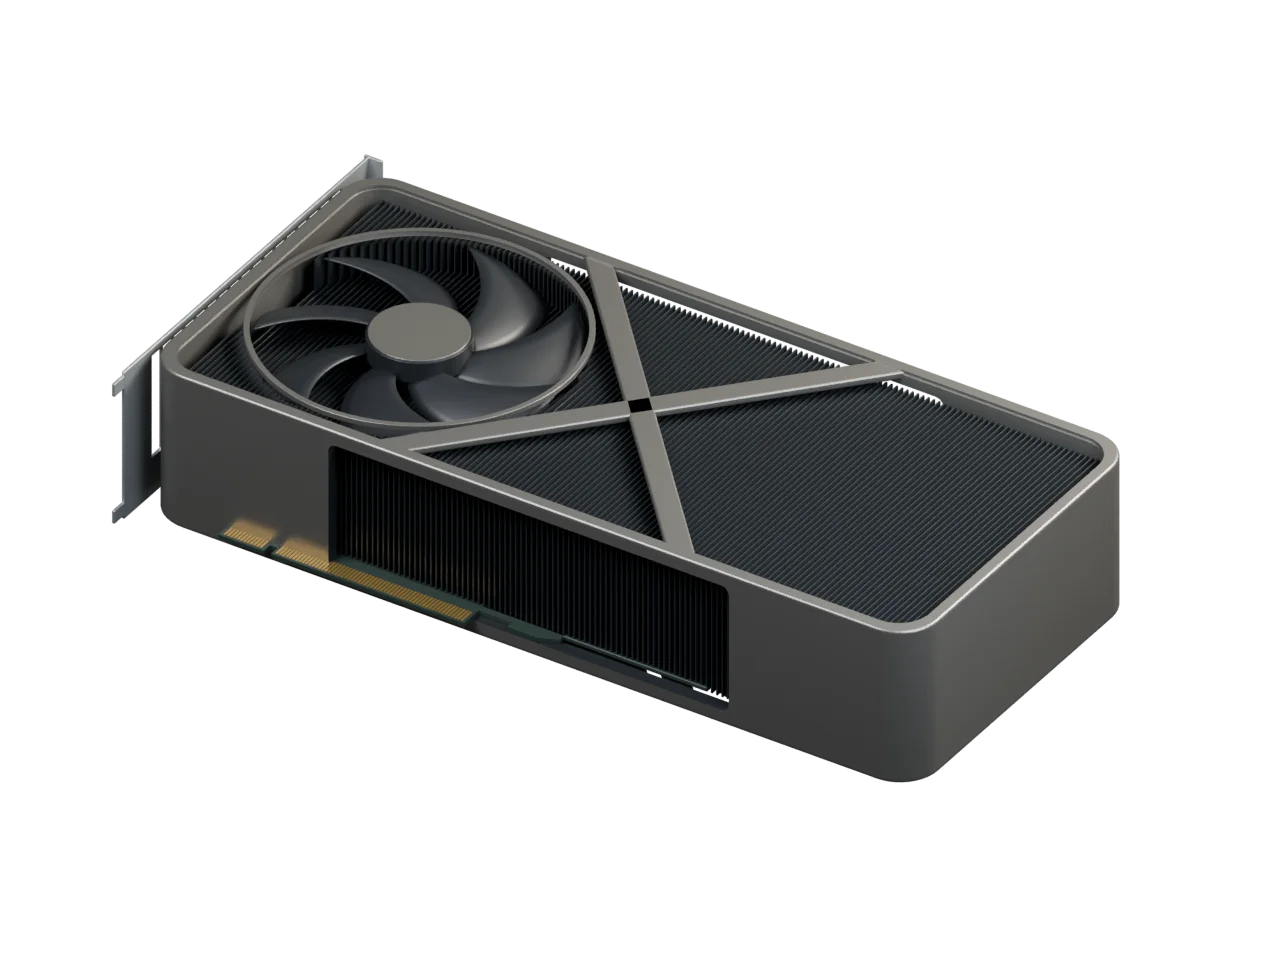
RTX 4090 · référence Founders Edition
Design représentatif. Le matériel du fournisseur peut différer.
Caractéristiques matérielles
Identiques chez tous les fournisseurs
Prix médian sur l'ensemble des fournisseurs
9 offres chez 8 fournisseurs
Triées par prix croissant. Comparez les configurations côte à côte.
| Fournisseur | Nombre | vCPU | RAM | Région | Par heure de GPU | Total/h | Action |
|---|---|---|---|---|---|---|---|
| ×1 | — | — | -- | 0,649 € | 0,65 € | Lancer | |
 Akash NetworkLe moins cher | ×1 | — | — |   | 0,246 € 0,0 % 30 j | 0,25 € | Lancer |
| ×1 | 0 | 101 GB |    +15 | À partir de0,351 € +50,6 % 30 j | À partir de0,35 € | Lancer | |
| ×8 | 88 | 228 GB | | À partir de0,368 € -12,7 % 30 j | À partir de2,95 € | Lancer | |
| ×1 | 12 | 70 GB |  | 0,386 € 0,0 % 30 j | À partir de0,39 € | Lancer | |
 Sesterce CloudLien affilié | ×8 | 88 | 228 GB | | À partir de0,386 € -16,7 % 30 j | À partir de3,09 € | Lancer |
 LiumLien affilié | ×1 | 10 | 10 GB |  | 0,509 € +65,7 % 30 j | À partir de0,51 € | Lancer |
 Novita AILien affilié | ×1 | 16 | 125 GB | | 0,588 € 0,0 % 30 j | 0,59 € | |
Jusqu'à438 €de crédit | ×1 | — | — | -- | 0,649 € | 0,65 € | Lancer |
| ×1 | 11 | 10 GB | | 1,052 € +71,4 % 30 j | 1,05 € | Lancer |


LLM qui tiennent sur le GPU NVIDIA RTX 4090
VRAM estimée des LLM à poids ouverts populaires en précision 16 bits (FP16/BF16), 8 bits (FP8/INT8) et 4 bits (INT4/MXFP4), pour 24 GB par GPU. Affichage des 12 plus grands qui tiennent.
| Modèle | Paramètres | 16 bits | 8 bits | 4 bits |
|---|---|---|---|---|
| DeepSeek V4 Flash DeepSeek | 284B | — Non publié | — Non publié | 192 GB Tient tout juste sur 8× ou 7× · 5 % de marge |
| Solar Open2 250B Upstage | 250B 15B actifs | — Non publié | 330 GB Juste sur 12× · 4 % de marge | 192 GB 9× · 24 GB libres ou 7× · 4 % de marge |
| Qwen3 235B-A22B Alibaba | 235B 22B actifs | — Non publié | 310 GB Juste sur 12× · 11 % de marge | 181 GB 8× · 11 GB libres ou 7× · 11 % de marge |
| Laguna-S 2.1 Poolside | 118B 8B actifs | 282 GB 12× · 5,8 GB libres | 155 GB 7× · 13 GB libres ou 6× · 11 % de marge | 90 GB 4× · 5,7 GB libres |
| gpt-oss-120b OpenAI | 117B 5,1B actifs | — Non publié | — Non publié | 78 GB 4× · 18 GB libres |
| Qwen3.6 35B-A3B Alibaba | 35B 3B actifs | 86 GB 4× · 9,7 GB libres | 47 GB Tient tout juste sur 2× | 28 GB 2× · 20 GB libres ou 1× · 4 % de marge |
| Qwen3 32B Alibaba | 32,8B | 79 GB 4× · 17 GB libres | 43 GB 2× · 4,8 GB libres | 25 GB 2× · 23 GB libres ou 1× · 14 % de marge |
| Gemma 4 31B Google | 31,3B | 75 GB 4× · 21 GB libres | 41 GB 2× · 6,7 GB libres | 24 GB 2× · 24 GB libres ou 1× · 19 % de marge |
| GLM-4.7 Flash Z.ai | 31,2B | 75 GB 4× · 21 GB libres | 41 GB 2× · 6,8 GB libres | 24 GB Tient tout juste sur 1× |
| Qwen3.6 27B Alibaba | 27,8B | 67 GB 4× · 29 GB libres | 37 GB 2× · 11 GB libres | 21 GB 1× · 2,7 GB libres |
| Mistral Small 3.2 24B Mistral AI | 24B | 58 GB 4× · 38 GB libres | 32 GB 2× · 16 GB libres | 18 GB 1× · 5,6 GB libres |
| gpt-oss-20b OpenAI | 21B 3,6B actifs | — Non publié | — Non publié | 17 GB 1× · 7,5 GB libres |
Estimations : poids du modèle plus 20 % pour le cache KV et le surcoût du runtime, avec des contextes courts. Les contextes longs et les lots importants demandent davantage. Les lignes marquées « juste » contiennent les poids, mais pas toute cette marge. Une valeur ×N correspond à la VRAM totale de N de ces GPU et ne préjuge en rien du débit de l'interconnexion. Notre méthode d'estimation · Partir plutôt d'un modèle
GPU similaires
Voir d'autres GPU similaires dans
Vous en voulez plus sur cette page ?
Des données erronées ?