* Nous pouvons percevoir une commission d'apport ou une commission de certains fournisseurs lorsque vous vous inscrivez via nos liens. Cela n'influence ni le classement ni l'ordre.
Historique des prix du GPU NVIDIA RTX 5090
Le prix médian du GPU NVIDIA RTX 5090 a baissé de 15 % depuis le 17 novembre 2025.
MédianeLe plus bas
Du 17 novembre 2025 au 11 novembre 2026, le prix médian est passé de 0,785 € à 0,669 € et le prix le plus bas de 0,187 € à 0,223 €.
LLM qui tiennent sur le GPU NVIDIA RTX 5090
LLM populaires à poids ouverts face à 32 GB par GPU : poids plus la place pour le cache KV, dans la meilleure précision qui tient. Affichage des 12 plus grands qui tiennent.
Tient sur un seul GPU NVIDIA RTX 5090
Qwen3.6 35B-A3B4 bits · 28 GB
Qwen3 32B4 bits · 25 GB
Gemma 4 31B4 bits · 24 GB
GLM-4.7 Flash4 bits · 24 GB
Qwen3.6 27B4 bits · 21 GB
Demande plusieurs GPU NVIDIA RTX 5090
GLM-5.216 GPU · 4 bits, juste
DeepSeek R116 GPU · 4 bits
DeepSeek V4 Flash8 GPU · 4 bits
Solar Open2 250B8 GPU · 4 bits
Qwen3 235B-A22B8 GPU · 4 bits
Laguna-S 2.13 GPU · 4 bits
gpt-oss-120b3 GPU · 4 bits
Tableau complet avec toutes les précisions
VRAM estimée des LLM à poids ouverts populaires en précision 16 bits (FP16/BF16), 8 bits (FP8/INT8) et 4 bits (INT4/MXFP4), pour 32 GB par GPU.
Estimations : poids du modèle plus 20 % pour le cache KV et le surcoût du runtime, avec des contextes courts. Les contextes longs et les lots importants demandent davantage. Les lignes marquées « juste » contiennent les poids, mais pas toute cette marge. Une valeur ×N correspond à la VRAM totale de N de ces GPU et ne préjuge en rien du débit de l'interconnexion. Notre méthode d'estimation · Partir plutôt d'un modèle
Caractéristiques du GPU NVIDIA RTX 5090
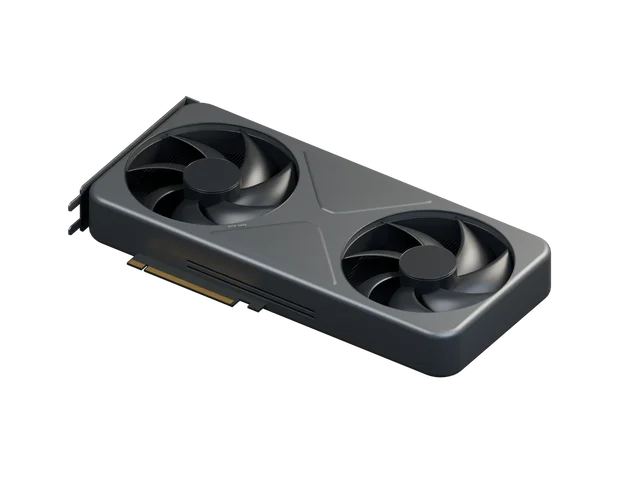
Carte grand public, le GPU NVIDIA RTX 5090 repose sur l'architecture Blackwell et dispose de 32 GB de mémoire, avec une bande passante mémoire de 1 792 GB/s et un TDP de 575 W. Il offre 104 TFLOPS de performances FP32.
Le GPU RTX 5090 démarre à 0,22 € par GPU-heure, avec une médiane de 0,67 € sur 78 configurations disponibles. Le prix réel dépend du fournisseur, de la région et du mode de location : à la demande, Spot ou réservé.
Quels fournisseurs cloud proposent le GPU RTX 5090 ?+–
15 fournisseurs proposent actuellement le GPU RTX 5090 : Sesterce Cloud, Runcrate, Novita AI, Akash Network, Vast.ai, Nova Cloud et 9 autres. Comparez leurs prix horaires, leurs régions et les caractéristiques des machines dans le tableau ci-dessus.
Combien de VRAM a le GPU RTX 5090 ?+–
Le GPU RTX 5090 dispose de 32 GB de VRAM, ce qui détermine les plus grands modèles et tailles de batch qu'il peut garder en mémoire pour l'entraînement et l'inférence.
Quels LLM puis-je faire tourner sur le GPU RTX 5090 ?+–
Avec 32 GB de VRAM, un seul GPU RTX 5090 peut servir des modèles comme Qwen3.6 35B-A3B, Qwen3 32B, Gemma 4 31B, GLM-4.7 Flash. Le tableau ci-dessus indique la VRAM estimée pour chaque modèle en précision 16 bits, 8 bits et 4 bits, y compris les configurations multi-GPU nécessaires aux plus grands modèles.
Quel est le plus grand LLM que je peux faire tourner sur plusieurs GPU RTX 5090 ?+–
Les plus grands modèles que nous suivons et qui tiennent sur plusieurs cartes RTX 5090 sont DeepSeek R1 sur 16 GPU en 4 bits, DeepSeek V4 Flash sur 8 GPU en 4 bits, Solar Open2 250B sur 8 GPU en 4 bits. Une configuration multi-GPU signifie que vous louez et payez chaque carte pendant toute la durée d'utilisation, et répartir un modèle sur plusieurs cartes coûte aussi du débit : les GPU échangent des activations à chaque token, donc les performances dépendent de la rapidité de leur interconnexion. Nous ne suivons pas l'interconnexion : vérifiez les caractéristiques du nœud auprès du fournisseur. Le tableau ci-dessus donne la plus petite configuration pour chaque modèle en précision 16 bits, 8 bits et 4 bits.
Où le GPU RTX 5090 est-il le moins cher ?+–
Le prix à la demande le plus bas que nous suivons actuellement pour le GPU RTX 5090 est de 0,22 € par GPU-heure, chez Theta EdgeCloud. Les fournisseurs modifiant fréquemment leurs prix et leur disponibilité, vérifiez le tableau en direct ci-dessus avant de lancer une instance.