NVIDIA L40S
Carte de classe entreprise, le GPU NVIDIA L40S repose sur l'architecture Ada Lovelace et dispose de 48 GB de mémoire, avec une bande passante mémoire de 864 GB/s et un TDP de 350 W. Il offre 91,6 TFLOPS de performances FP32 et 362 TFLOPS de performances tensorielles FP16. Actuellement disponible chez 10 fournisseurs à partir de 0,41 €/GPU/heure, avec une médiane du marché de 0,96 €/GPU/heure sur 49 configurations.
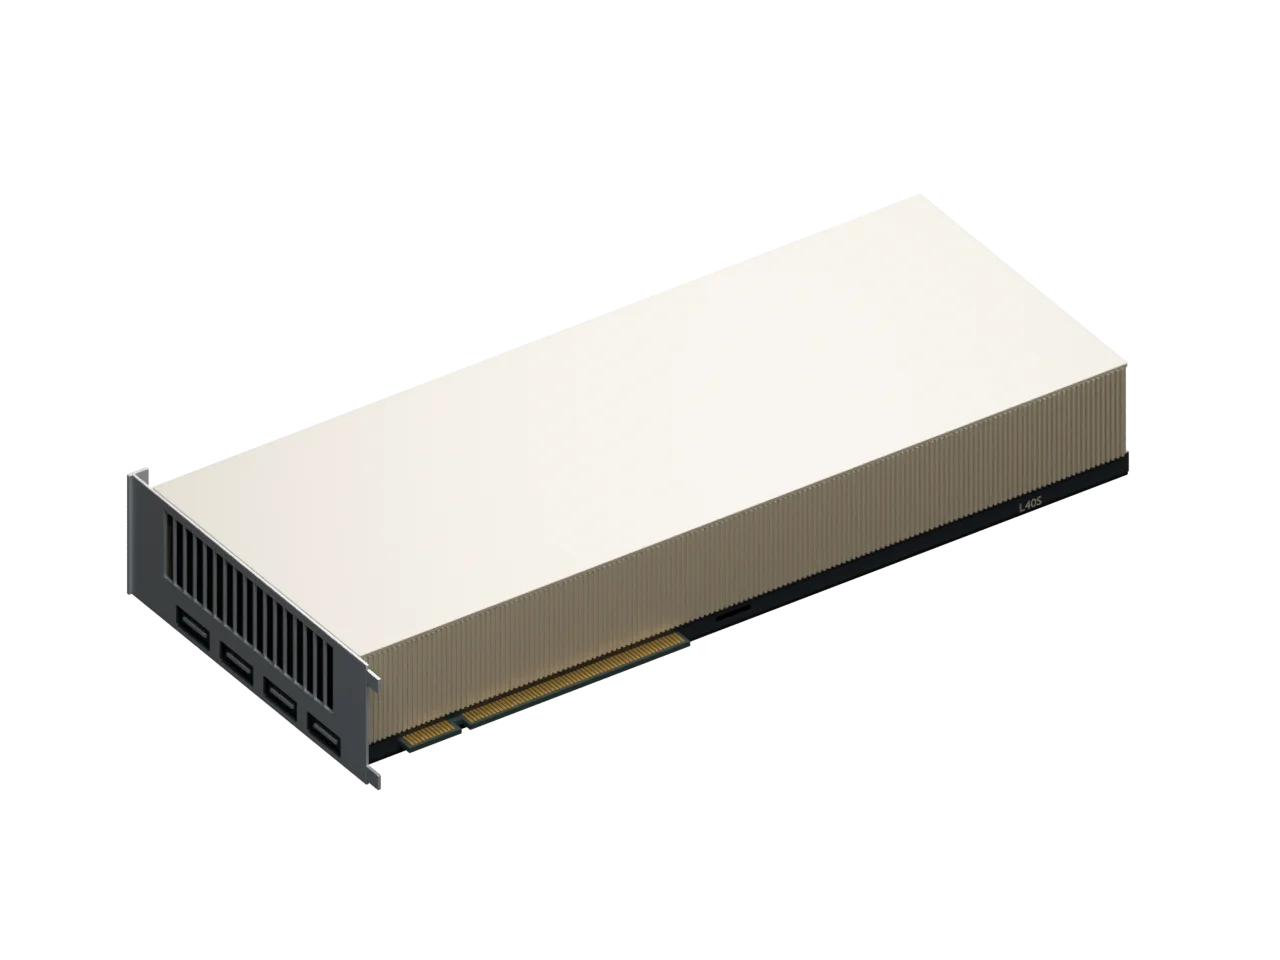
L40S · design de référence PCIe
Design représentatif. Le matériel du fournisseur peut différer.
Caractéristiques matérielles
Identiques chez tous les fournisseurs
Prix médian sur l'ensemble des fournisseurs
11 offres chez 10 fournisseurs
Triées par prix croissant. Comparez les configurations côte à côte.
| Fournisseur | Nombre | vCPU | RAM | Région | Par heure de GPU | Total/h | Action |
|---|---|---|---|---|---|---|---|
| ×1 | 16 | 188 GB | -- | 0,956 € | 0,96 € | Lancer | |
| ×4 | 128 | 503 GB |    +4 | À partir de0,412 € 0,0 % 30 j | À partir de1,65 € | Lancer | |
 Novita AILien affilié | ×1 | 22 | 125 GB |    +7 | 0,482 € | 0,48 € | |
| ×2 | 44 | 256 GB |  | À partir de0,811 € -24,2 % 30 j | À partir de1,62 € | Lancer | |
| ×1 | 12 | 72 GB |  | 0,851 € 0,0 % 30 j | À partir de0,85 € | Lancer | |
Jusqu'à438 €de crédit | ×1 | 16 | 188 GB | -- | 0,956 € 0,0 % 30 j | 0,96 € | Lancer |
Jusqu'à1 €de crédit | ×8 | 64 | 1,5 TB | | À partir de1,099 € -0,4 % 30 j | À partir de8,79 € | Lancer |
| ×8 | 160 | 480 GB | -- | À partir de1,353 € +10,5 % 30 j | À partir de10,82 € | Lancer | |
| ×1 | 16 | 180 GB | -- | À partir de1,368 € | À partir de1,37 € | Lancer | |
 Sesterce CloudLien affilié | ×10 | 80 | 1,44 TB | | À partir de1,447 € 0,0 % 30 j | À partir de14,47 € | Lancer |
| ×1 | 8 | 96 GB | | 1,470 € -2,1 % 30 j | À partir de1,47 € | Lancer | |
| ×1 | 12 | 72 GB | | 1,579 € 0,0 % 30 j | À partir de1,58 € | Lancer |




LLM qui tiennent sur le GPU NVIDIA L40S
VRAM estimée des LLM à poids ouverts populaires en précision 16 bits (FP16/BF16), 8 bits (FP8/INT8) et 4 bits (INT4/MXFP4), pour 48 GB par GPU. Affichage des 12 plus grands qui tiennent.
| Modèle | Paramètres | 16 bits | 8 bits | 4 bits |
|---|---|---|---|---|
| DeepSeek R1 DeepSeek | 671B 37B actifs | — Non publié | 826 GB Trop grand | 481 GB Juste sur 10× · 19 % de marge |
| DeepSeek V4 Flash DeepSeek | 284B | — Non publié | — Non publié | 192 GB Tient tout juste sur 4× |
| Solar Open2 250B Upstage | 250B 15B actifs | 601 GB Trop grand | 330 GB 7× · 5,6 GB libres | 192 GB 7× · 144 GB libres ou 4× · 19 % de marge |
| Qwen3 235B-A22B Alibaba | 235B 22B actifs | 564 GB Juste sur 10× · 2 % de marge | 310 GB 7× · 26 GB libres | 181 GB 4× · 11 GB libres |
| Laguna-S 2.1 Poolside | 118B 8B actifs | 282 GB 7× · 54 GB libres | 155 GB 4× · 37 GB libres ou 3× · 11 % de marge | 90 GB 2× · 5,7 GB libres |
| gpt-oss-120b OpenAI | 117B 5,1B actifs | — Non publié | — Non publié | 78 GB 2× · 18 GB libres |
| Qwen3.6 35B-A3B Alibaba | 35B 3B actifs | 86 GB 2× · 9,7 GB libres | 47 GB Tient tout juste sur 1× | 28 GB 1× · 20 GB libres |
| Qwen3 32B Alibaba | 32,8B | 79 GB 2× · 17 GB libres | 43 GB 1× · 4,8 GB libres | 25 GB 1× · 23 GB libres |
| Gemma 4 31B Google | 31,3B | 75 GB 2× · 21 GB libres | 41 GB 1× · 6,7 GB libres | 24 GB 1× · 24 GB libres |
| GLM-4.7 Flash Z.ai | 31,2B | 75 GB 2× · 21 GB libres | 41 GB 1× · 6,8 GB libres | 24 GB 1× · 24 GB libres |
| Qwen3.6 27B Alibaba | 27,8B | 67 GB 2× · 29 GB libres | 37 GB 1× · 11 GB libres | 21 GB 1× · 27 GB libres |
| Mistral Small 3.2 24B Mistral AI | 24B | 58 GB 2× · 38 GB libres | 32 GB 1× · 16 GB libres | 18 GB 1× · 30 GB libres |
Estimations : poids du modèle plus 20 % pour le cache KV et le surcoût du runtime, avec des contextes courts. Les contextes longs et les lots importants demandent davantage. Les lignes marquées « juste » contiennent les poids, mais pas toute cette marge. Une valeur ×N correspond à la VRAM totale de N de ces GPU et ne préjuge en rien du débit de l'interconnexion. Notre méthode d'estimation · Partir plutôt d'un modèle
Vous en voulez plus sur cette page ?
Des données erronées ?